
 PC版
 在线投稿
向量级稀疏的独创性突破|星凡智能稀疏论文在Wiley高水平期刊发表
大模型进入实际应用,首先要过资源约束这一关:参数越多,存储和计算需求越高。对于需要控制功耗、空间和响应时间的物理终端,这道题尤其现实。
所谓稀疏化,可以理解为给模型“减员”:让一部分权重不再参与计算,使模型有机会用更少资源运行。论文中以“2:4”稀疏实验为例,就是每组4个权重里保留2个、停用2个。
但不是随便让谁退场都行。权重原本相互配合,少了一部分,模型可能就答不好问题。我们要解决的,就是让模型变轻的同时,尽量保住模型原有的能力。
近日,由星凡智能首席算法科学家、董事/合伙人谭铭玺主导的算法团队在Advanced Intelligent Systems正式发表《Vector-Based SparseGPT: A Vector-Based Sparsity Method for Large Language Model》(《基于向量的SparseGPT:一种面向大语言模型的向量级稀疏化方法》)。该刊是Wiley旗下Advanced系列国际学术期刊,聚焦人工智能、机器人与自动化等智能系统研究。
论文提出向量级稀疏方法 V-SparseGPT,通过改进权重删除与误差补偿机制,在无需额外微调的情况下,降低模型稀疏化带来的性能损失。在业界公认的基准模型LLaMA-3-70B的2:4稀疏实验中(非微调下),相较SparseGPT,V-SparseGPT将困惑度(PPL)从10.97降至7.36,降幅达32.91%,性能极佳。
01|删去权重之后,误差如何补回来?
权重可以理解为模型计算中使用的一组参数。稀疏化将其中一部分置零,减少有效参数。以2:4稀疏为例(非微调),在指定权重矩阵中,每组四个权重保留两个。
打个比方,一支四人乐队需要精简为两人。人员减少后,原来的声部也需要重新安排,让留下的两位乐手尽量保留整首曲子的演奏效果。模型删去权重后,同样需要调整保留权重,补偿原先由其他权重承担的部分作用。
然而,业界以往的稀疏方法在这一步上选择了两条路:
•第一种思路,将乐队中的每位乐手视为独立个体,逐一简单替换——“你走了,你来顶上”。这种方法太过简单,完全忽略了乐手之间的协作关系,效果自然大打折扣。
•第二种思路,替换之后通过训练来进行多次”彩排”——让留下的乐手反复练习,试图找回丢失的默契。这种方法虽然理论上可行,但太繁琐、耗时耗力,在大模型规模下几乎不可行。
星凡智能所提出的V-SparseGPT,则走出了一条全新路径: 它考虑到乐手之间的协作关系,不需要反复”彩排”,就像一位优秀的指挥家,用一种更优美的方法在调度一个乐队——不是逐个替换、也不是反复排练,而是统筹全局、一次性给出最优安排。这是以往稀疏方法从未考虑过的视角,也是星凡智能独创性技术的核心所在。
SparseGPT是已有的开源大模型剪枝方法,本文将其作为对比基线。它按顺序处理权重,并在剪除权重后补偿其余权重。V-SparseGPT则把处理推进到向量级:在相应范围内同步处理待剪权重,并联合调整保留权重,减少逐步处理可能带来的误差累积。
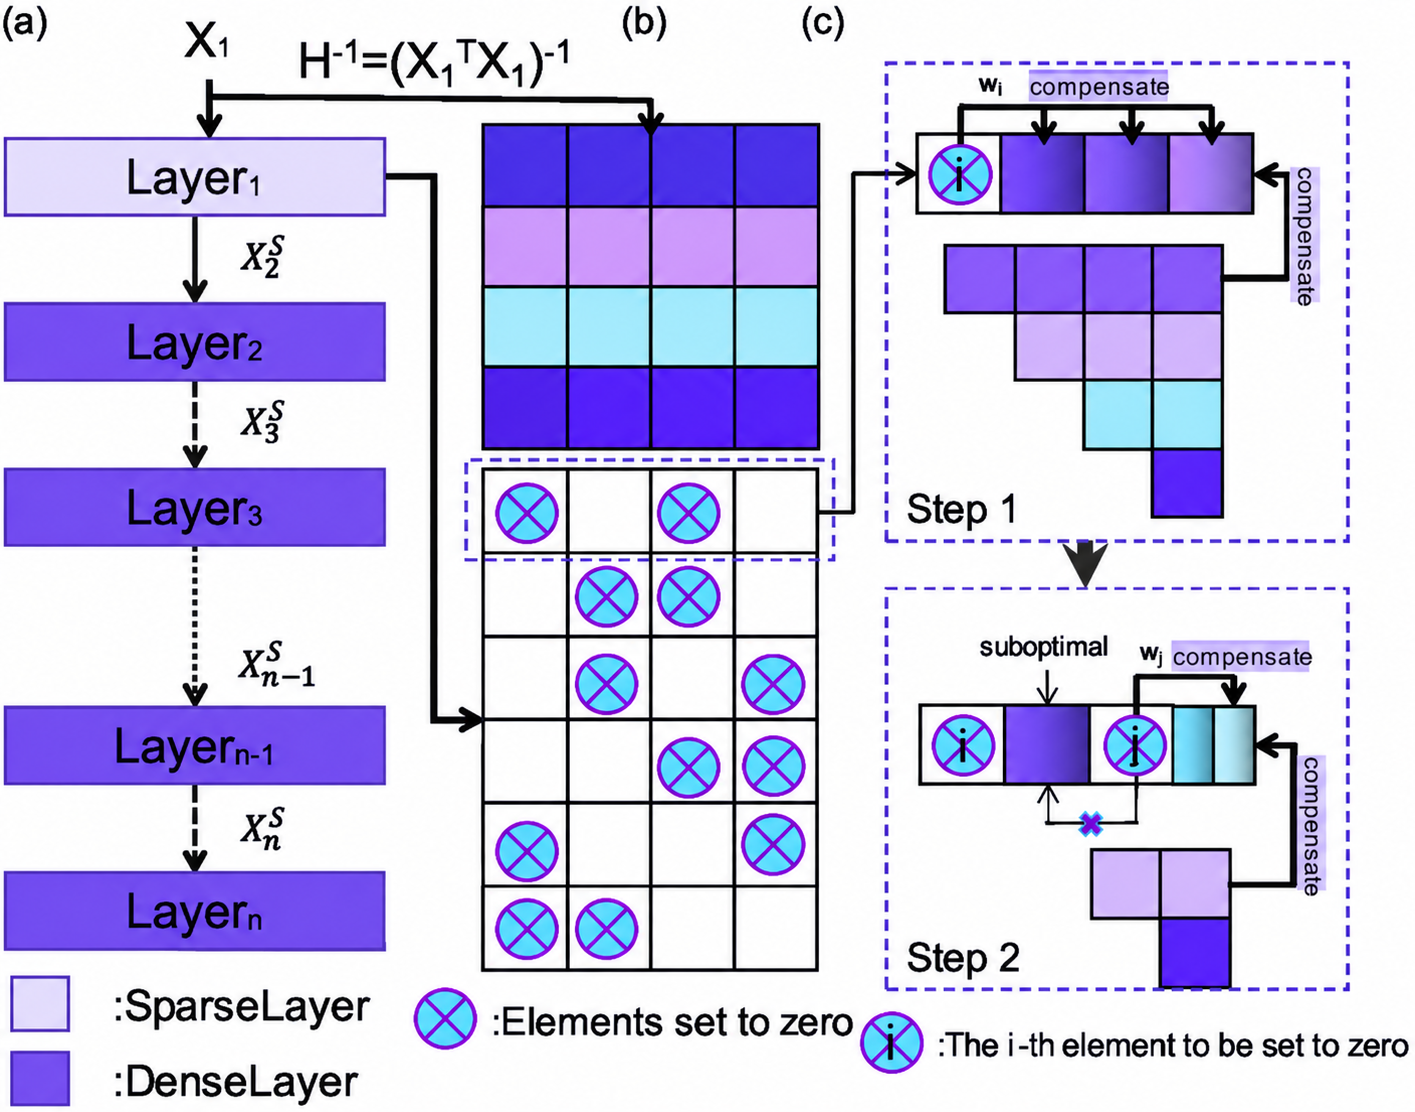
SparseGPT的串行稀疏与权重补偿过程。右侧展示依次删除权重、逐步补偿的处理方式。
图片来源:论文 Figure 1
这使大模型剪枝面临一个关键问题:在既定稀疏比例下,如何让保留权重更好地协同,减少模型能力损失?
02|全新方法:从逐个处理,走向向量级联合补偿
围绕这一问题,V-SparseGPT将处理单位推进到向量级:在相应处理范围内,同时将选定权重置零,并联合更新保留参数。
沿用乐队的例子:如果先让一位乐手退出、临时调整声部,随后再让另一位退出,前一次安排可能又受到影响。向量级联合补偿的思路,可以理解为把两位乐手退出留下的缺口一起考虑,再统一调整保留者的演奏安排,减少反复调整带来的误差。这就像一位卓越的指挥家,不是等一位乐手走了再找替补、再排练,而是站在指挥台上,一眼看完整支乐队的声部配置,一次性给出最优的调度方案——优雅、高效、无需彩排。
论文从二阶误差分析出发,推导权重补偿关系,并在删除位置相同的条件下比较两种方法的误差,从而检验补偿机制本身的作用。
为使向量级方法的效率更高,研究团队进一步引入分块稀疏与层间并行稀疏两项策略。
分块稀疏将大矩阵拆分为较小的处理单元,降低计算复杂度,并将块内处理产生的误差向后续部分传递。层间并行稀疏则预先记录原模型各层输入,使多个层的稀疏处理能够并行推进,减少层与层之间的串行等待。
这类似排练一场大型演出:先把节目拆成较小的段落,再让不同排练组依据原始节目资料同时准备。拆分任务、减少等待,有助于提高准备效率;各部分之间的衔接仍需要协调。
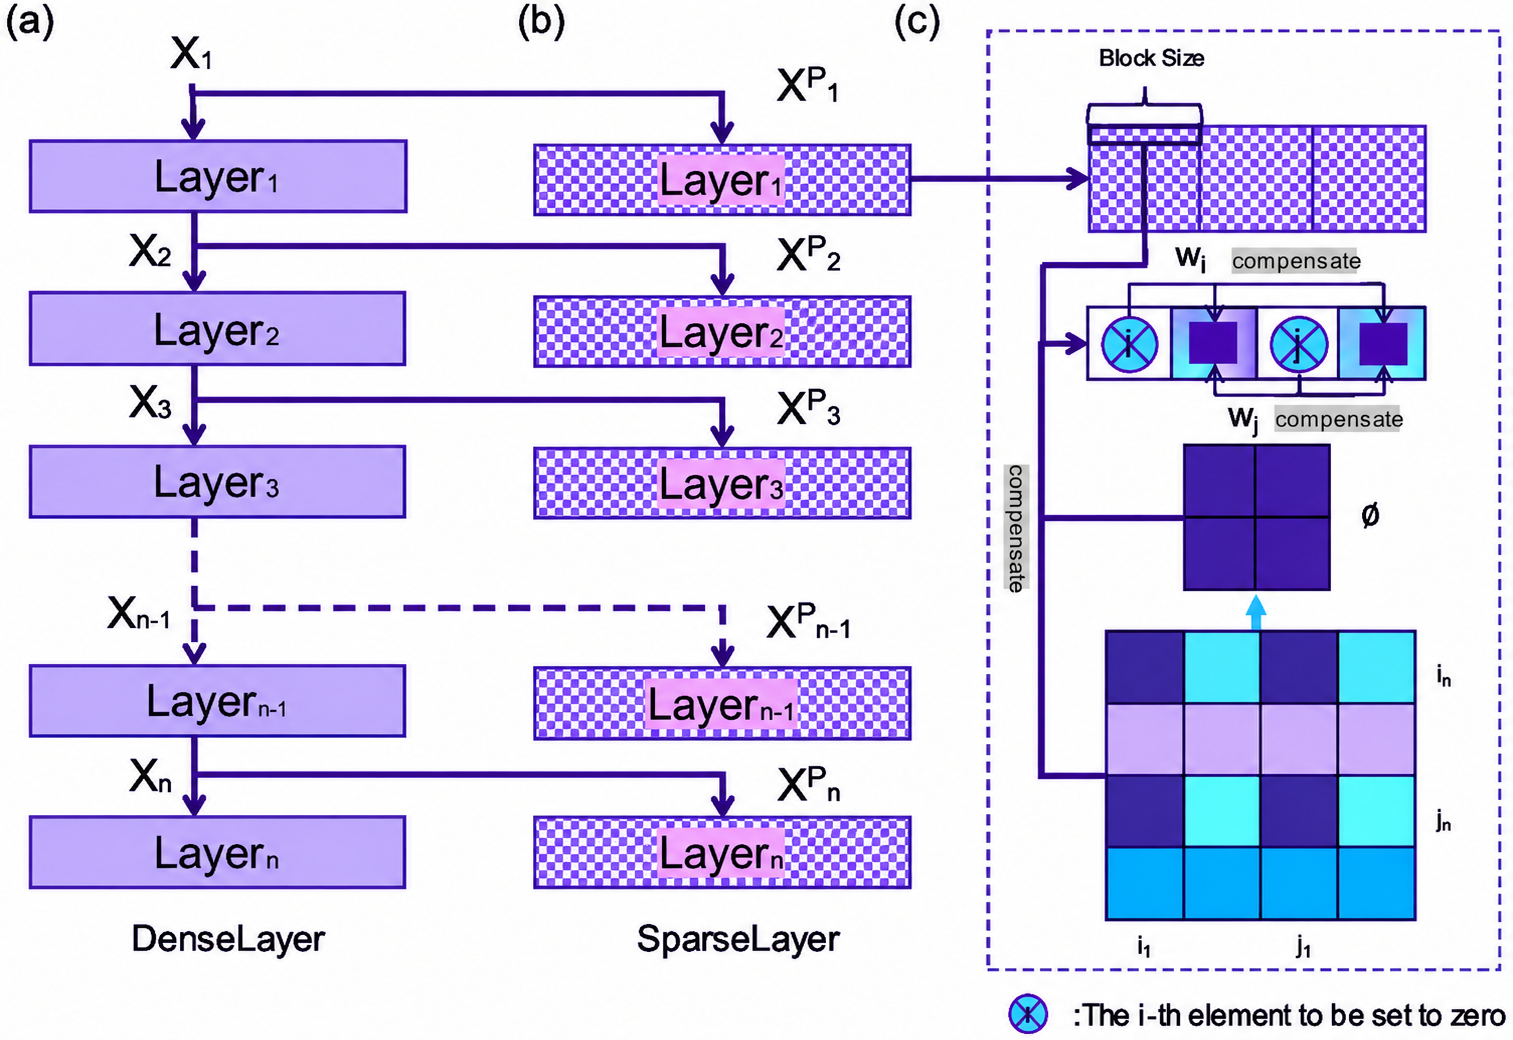
V-SparseGPT整体框架
(a)原模型前向过程;(b)层间并行稀疏;(c)分块与向量级权重补偿。
图片来源:论文 Figure 2
研究还发现,分块大小会影响最终模型表现,不同子层对分块的敏感程度也存在差异。因此,分块策略需要结合模型结构进行选择,在误差控制与处理开销之间寻找合适的平衡。
向量级补偿控制误差,分块降低求解复杂度,层间并行提高处理效率,共同构成了V-SparseGPT的完整框架。
03|相同稀疏条件,模型表现改善多少?
论文在LLaMA、Qwen2.5等系列模型上开展实验,对比不同稀疏方法的模型表现。后训练稀疏情况下,在业界同类稀疏方法中,V-SparseGPT取得了行业最佳的性能表现,而且可以媲美自适应微调的稀疏方法。
以2:4稀疏条件(非微调)下的结果为例:
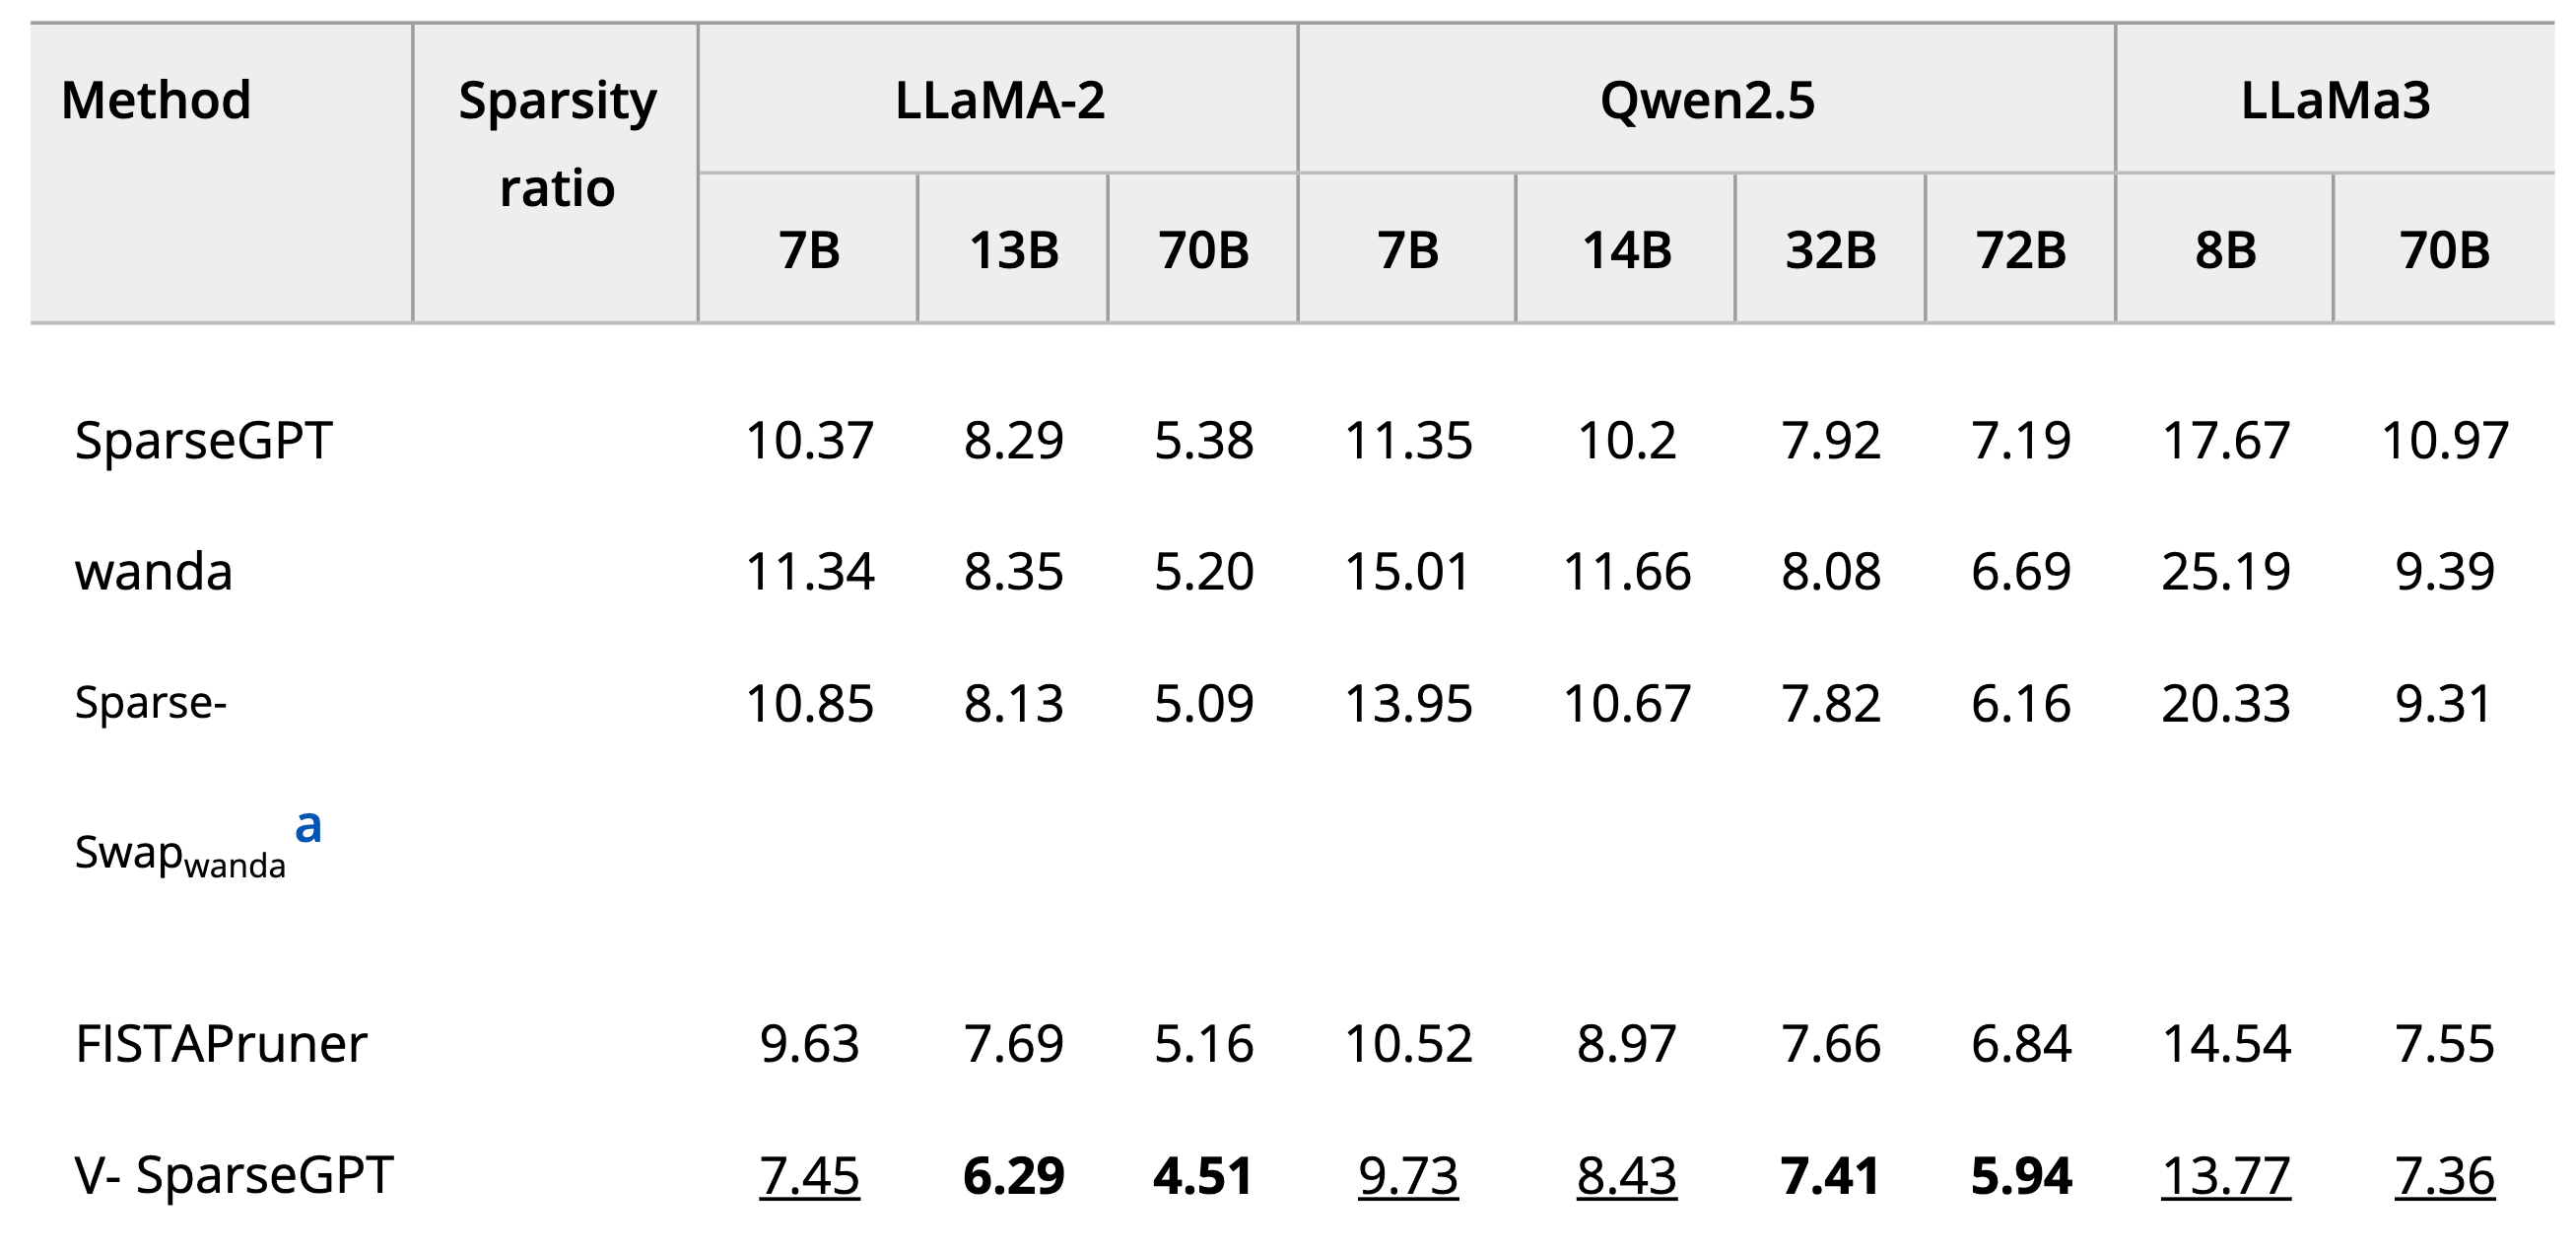
2:4结构化稀疏下,不同后训练稀疏化方法的剪枝耗时与PPL对比
PPL(困惑度)越低,表示模型在该项测试中的预测表现越好
图片来源:论文原文 Table 2
可以把语言模型想成不断做“接下一个词”的练习。例如看到“今天下雨了,出门记得带……”时,模型需要预测后面可能出现的内容。在一整套测试文本上,模型对真实后续内容给出的预测越合理,PPL通常越低。
三组对照中,V-SparseGPT均取得更低的PPL。其中,业界公认的基准模型LLaMA-3-70B的降幅高达32.91%,堪称业界性能王者。
论文还在零样本语言任务中检验稀疏后的任务能力。在所比较的后训练稀疏方法中,V-SparseGPT在六项语言任务中的四项取得最佳结果、两项取得次优的结果,为其效果提供了PPL之外的验证。
在满足规律稀疏结构的同时,获得性能损失更小的模型,为后续硬件适配提供更好的模型基础。
04|从一项稀疏研究,看星凡智能的算法体系
V-SparseGPT是星凡智能面向模型高效运行的一项研究成果。围绕大模型部署,公司持续布局混合精度量化、低比特计算、稀疏优化与自研推理引擎:根据模型各部分的精度需求配置计算位宽,减少存储与计算开销,并通过算子优化和硬件适配推动模型高效执行。
这些能力通过XBoost软件平台与星核系列产品向部署环节延伸。其中,星核S1原生支持INT2、INT3、INT4、INT6、INT8混合精度计算,为不同精度模型提供硬件基础。模型侧控制压缩误差,软件栈优化执行过程,芯片承接相应计算需求,共同服务机器人、卫星与边缘终端在有限资源下的智能运行。
以向量级稀疏的独创性突破,铸就业界性能王者。如指挥家调度乐队般优雅,无需彩排,即达最优。
责编:陈方
一审:陈方
二审:汤世明
三审:田从梅
来源:华声在线
免责声明:华声在线对文中陈述、观点判断保持中立,不对所包含内容的准确性、可靠性或完整性提供任何明示或暗示的保证。文章仅是作者个人观点,不应作为投资依据。读者应详细了解所有相关投资风险,并请自行承担全部责任。
文章是网络作者投稿发布,版权归投稿作者所有。作者应对文章及图片的真实性及版权负责。一旦因此引发版权纠纷,权利人提出异议,华声在线将根据相关法律法规的规定,删除相应内容。侵权责任由投稿者自行承担,如由此造成华声在线损失,投稿者应承担赔偿责任。如对本文有任何异议,请联系我们38160107#(#改成@)qq.com。

